library("tidymodels")  # Train- und Test-Sample aufteilen
library("tidyverse")  # data wrangling
library("conflicted")  # Name clashes finden
library("easystats") # stats made easy370 flights-delay
lm
regression
interaction
yacsda
Schlüsselwörter
Aufgaben, Statistik, Prognose, Modellierung, R, Datenanalyse, Regression
370.1 Hintergrund und Forschungsfrage
Wir untersuchen die Forschungsfrage Was sind Prädiktoren von Flugverspätungen. Dazu nutzen wir lineare Modelle als Modellierungsmethoden.
Dieser Post knüpft an den Post zur explorativen Datenanalyse der Flugverspätungen an (es gibt auch hier, Teil 1 und hier, Teil 2 ein Video zu diesem EDA-Post).
370.2 Setup
370.2.1 Pakete laden
Wirklich wichtig sind nur tidymodels und tidyverse. Die restlichen Pakete werden nur am Rande benötigt. Man sollte auch nur die Pakete laden, die man für die Analyse benötigt.
370.2.2 Daten laden: Flights 2023
Aus Gründen der Datenökonomie nutzen wir eine kleinere Version des Datensatz flights. Wir nutzen nicht mehr die Daten aus dem 2013, sondern die neueren Daten aus dem Jahr 2023.
library(nycflights23)
data(flights)

set.seed(42)  # Reproduzierbarkeit
flights <-
  flights |>
  sample_n(size = 3e4)
Achtung: flights ist recht groß; die Regressionsmodelle können leicht ein paar Hundert Megabyte groß werden. Das bringt u.U. auch einen modernen Computer irgendwann ins Straucheln.
370.3 flights2: Nicht benötigte Variablen entfernen und ID hinzufügen
370.4 Aufteilung in Train- und Testsample
Der Hintergrund zur Idee der Aufteilung in Train- und Test-Stichprobe kann z.b. hier oder hier, Kapitel 15, nachgelesen werden.
flights_split <- initial_split(flights2,
                               strata = dep_delay)
370.5 flights_train2, flights_test2
set.seed(42)  # Reproduzierbarkeit
flights_train2 <- training(flights_split)
flights_test2 <- testing(flights_split)
Die “wirkliche Welt” (was immer das ist) besorgt die Aufteilung von Train- und Test-Sampel für Sie automatisch. Sagen wir, Sie arbeiten für die Flughafen-Aufsicht von New York. Dann haben Sie einen Erfahrungsschatz an Flügen aus der Vergangenheit in Ihrer Datenbank (Train-Sample). Einige Tages kommt Ihr Chef zu Ihnen und sagt: “Rechnen Sie mir mal die zu erwartende Verspätung der Flüge im nächsten Monat aus!”. Da heute nicht klar ist, wie die Verspätung der Flüge in der Zukunft (nächsten Monat) sein wird, stellen die Flüge des nächsten Monats das Test-Sample dar.
Übrigens: In der Prüfung besorgt das Aufteilen von Train- und Test-Sample netterweise Ihr Dozent…
370.6 lm0: Nullmodell
Eigentlich nicht nötig, das Nullmodell, primär aus didaktischen Gründen berechnet, um zu zeigen, dass in diesem Fall \(R^2\) wirklich gleich Null ist.
lm0 <- lm(dep_delay ~ 1, data = flights_train2)
model_parameters(lm0)  # model_parameters zeit die (geschätzten) Regressionsgewichte (Betas)
Wir könnten anstatt model_parameters auch parameters nutzen; das ist der gleiche Befehl.
Allerdings gibt es den Befehl parameters in zwei Paketen, es käme also zu einem “Name Clash”. Das umgehen wir, indem wir model_parameter nutzen, und nicht parameters.
370.7 lm1: origin
lm1 <- lm(dep_delay ~ origin, data = flights_train2)
model_parameters(lm1)
Man vergleiche:
Der Mittelwertsvergleich und das Modell lm1 sind faktisch informationsgleich.
Aber leider ist es um die Modellgüte nicht so gut bestellt (eigentlich eher “grottenschlecht”):
r2(lm1)
## # R2 for Linear Regression
##        R2: 0.002
##   adj. R2: 0.002
lm1 ist so schlecht, wir löschen es gleich wieder…
rm(lm1)370.8 lm2: All in
# NICHT AUSFÜHREN
#lm2_all_in <- lm(dep_delay ~ ., data = flights_train2)
Modell lm2_all_in ist hier keine gute Idee, da nominale Prädiktoren in Indikatorvariablen umgewandelt werden. Hat ein nominaler Prädiktor sehr viele Stufen (wie hier), so resultieren sehr viele Indikatorvariablen, was dem Regressionsmodell Probleme bereiten kann (bei mir hängt sich R auf). Besser ist es in dem Fall, die Anzahl der Stufen von nominalskalierten Variablen vorab zu begrenzen.
Bei kleineren Datensätzen (weniger Variablen, weniger Fälle) lohnt es sich aber oft, das “All-in-Modell” auszuprobieren, als Referenzmaßstab für andere Modelle.
370.9 flights_train3: Textvariablen in Faktorvariablen umwandeln
Begrenzen wir zunächst die Anzahl der Stufen der nominal skalierten Variablen:
Wem das across zu kompliziert ist, der kann auch alternativ (synonym) jede Variable einzeln in einen Faktor umwandeln und zwar so:
Das ist einfacher als mit across, aber dafür mehr Tipperei.
Wir müssen die Transformationen, die wir auf das Train-Sample anwenden, auch auf das Test-Sample anwenden:
370.10 flights_test3
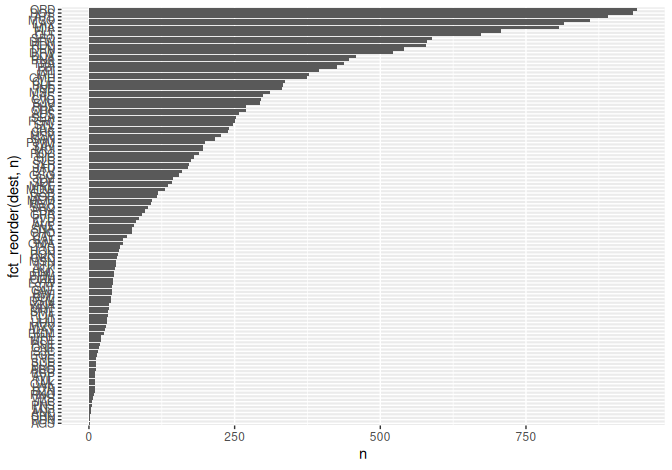
Z.B. dest hat viele Stufen:
370.11 flights_train4: Faktorstufen zusammenfassen
370.12 Variante mit fact_lump_n
Sinngemäß bedeutet das:
“Fasse die Faktorstufen von dest zu 8 Gruppen plus einer ‘Lumpensammler-Kategorie’ zusammen.”
flights_train3 %>%
  mutate(dest_lump9 = fct_lump_n(dest, n = 8)
  )
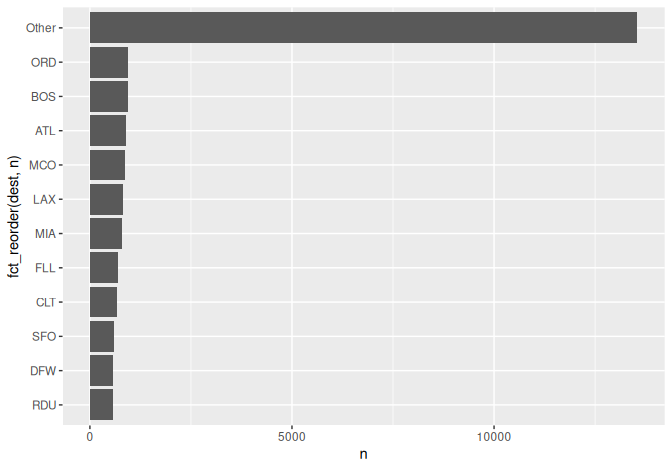
Hier sind die Faktorstufen von dest:
flights_train4$dest |> levels()
##  [1] "ATL"   "BOS"   "CLT"   "DFW"   "FLL"   "LAX"   "MCO"   "MIA"   "ORD"
## [10] "RDU"   "SFO"   "Other"
Visusalsieren wir die Häufigkeit der Faktorstufen:
370.13 flights_test4
Vergessen wir nicht, die Transformation auch auf das Test-Sample anzuwenden:
Wichtig! Im Alle Faktorstufen, die im Test-Set vorkommen, müssen auch im Train-Set vorkommen. Sonst können wir das Regressionsmodell nicht berechnen.
levels(flights_test4$dest)
##  [1] "ATL"   "BOS"   "CLT"   "DFW"   "FLL"   "LAX"   "MCO"   "MIA"   "ORD"
## [10] "Other"levels(flights_train4$dest)
## [1] "ATL" "BOS" "CLT" "DFW" "FLL" "LAX" "MCO" "MIA" "ORD"
## [10] "RDU" "SFO" "Other"Das sieht gut aus: Alle Faktorstufen im Test-Set sind im Train-Set enthalten.
370.14 lm3: Alle zusammengefassten Faktorvariablen
Achtung! Falls ein Faktor nur über eine einzige Faktorstufe verfügt, wird das Regressionsmodell zusammenbrechen mit einer Fehlermeldung. Adios!
Der Punkt bei dep_delay ~ . meint “nimm alle Variablen im Datensatz (bis auf dep_delay)”.
Der Punkt bei data = . nimm die Tabelle, wie sie dir im letzten Schritt mundgerecht aufbereitet wurde. Man hätte hier auch flights_train4 schreiben können, aber dann hätten wir noch tailnum etc. entfernen müssen.
Eigentlich brauchen wir nicht so viele Dezimalstellen …
options(digits = 2)model_parameters(lm3) # Modellkoeffizienten, also die Beta-Gewichte ("estimate")Wie man sieht, wird eine nominalskalierte Variable mit vielen Stufen in entsprechend (viele!) binäre Variablen umgewandelt, die jeweils einen Regressionskoeffizienten ergeben.
r2(lm3)  # R^2
## # R2 for Linear Regression
##        R2: 0.016
##   adj. R2: 0.015
Ein mageres R-Quadrat.
370.15 lm4: Alle metrischen Variablen
Was sind noch mal unsere metrischen Variablen:
Ok, jetzt eine Regression mit diesen Variablen (ober ohne die ID-Variable):
r2(lm4)
## # R2 for Linear Regression
##        R2: 0.061
##   adj. R2: 0.061
Tja, das \(R^2\) hat einen nicht gerade um …
370.16 lm5: Alle metrischen und alle (zusammengefassten) nominalen Variablen
Welche Variablen sind jetzt alle an Bord?
time_hour nehmen wir noch einmal raus, da es zum einen redundant ist zu hour etc. und zum anderen noch zusätzlicher Aufbereitung bedarf.
r2(lm5)
## # R2 for Linear Regression
##        R2: 0.068
##   adj. R2: 0.067
Der Vorhersage-Gott ist nicht mit uns. Vielleicht sollten wir zu einem ehrlichen Metier als Schuhverkäufer umsatteln …
370.17 flights_train5: Fehlenden Werte ersetzen
flights_train4 |>
  describe_distribution() |>
  select(Variable, n_Missing)
Glücklicherweise haben wir nicht zu viele fehlende Werte. Bei der Größe der Stichprobe fällt die Anzahl wenig ins Gewicht. Aber zu Übungszwecken ersetzen wir mal die fehlenden Werte.
flights_train5 <-
  flights_train4 |>
  mutate(air_time = replace_na(air_time, mean(air_time, na.rm = TRUE)))
370.18 lm6: Wie lm5, aber ohne fehlende Werte
lm6 <-lm(dep_delay ~ ., data = flights_train5)r2(lm6)
## # R2 for Linear Regression
## R2: 0.068
## adj. R2: 0.067370.19 flights_train6: Extremwerte entfernen
library(DataExplorer)

flights_train5 |>
  select(where(is.numeric)) |>
  plot_density()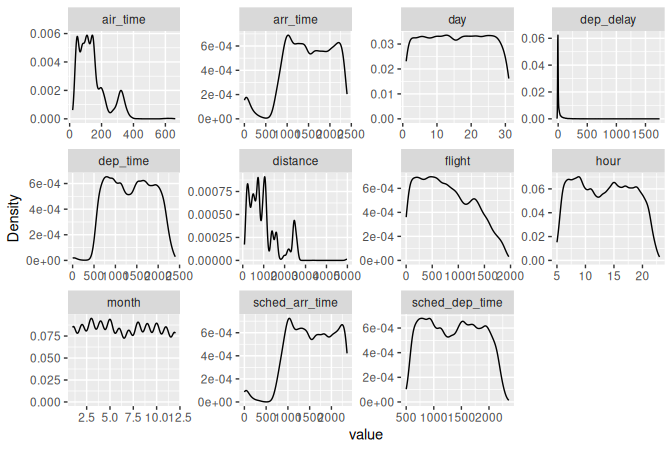
Es sieht so aus, als wäre air_time deutlich rechtsschief mit einigen Ausreißern.
Betrachten wir noch Boxplots, die auch gut Extermwerte visualisieren.
flights_train5 |>
  select(where(is.numeric), "origin") |>
  plot_boxplot(by = "origin")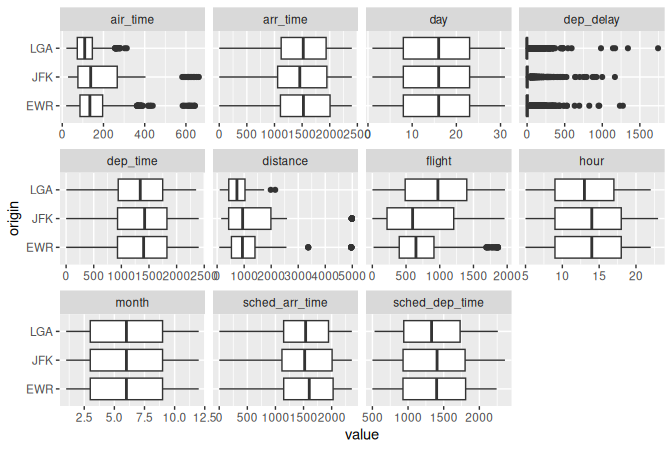
Eine gängige Methode, mit Extermwerten umzugehen, ist, alle Datenpunkte, die im Boxplot als alleinstehende Punkte gezeigt werden, durch den Median zu ersetzen. Achtung: Diese Methode ist nicht perfekt! Es gibt viel sophistiziertere Methoden.
Wir ersetzen dabei alle Werte von air_time, für die gilt, dass sie größer sind als Q3 + 1.5*IQR.
Q3:
IQR:
Der Grenzwert ist also:
Der Median von air_time beträgt übrigens:
Grob auf Deutsch übersetzt:
Wenn ein Flug eine
air_timevon mehr als 326 Minuten hat, dann sei die airtime gleich 122, ansonsten immer (“TRUE”) ist airtime gleichair_time, bleibt also, wie sie war.
370.20 lm7: Wie lm5, aber ohne Extremwerte für air_time
lm7 <-lm(dep_delay ~ ., data = flights_train6)

r2(lm7)
## # R2 for Linear Regression
##        R2: 0.069
##   adj. R2: 0.067
Tja….
370.21 R2 im Testsample
\(R^2\) kann man übrigens auch so berechnen:
Zuerst fügen wir die Vorhersagen zum Datensatz hinzu:
Dann berechnen wir das R-Quadrat mit der Funktion rsq (wie “r squared”) anhand der beiden relevanten Spalten:
flights_train7_pred %>%
  rsq(truth = dep_delay,
      estimate = lm7_pred)
Berechnen wir jetzt die Modellgüte im Testsample.
Fügen wir die Vorhersagewerte dem Testsample dazu:
Check:
Am schwierigsten ist es, bei den ganzen Nummerierungen nicht durcheinander zu kommen. Hier könnte es sich lohnen, ein übersichtlicheres Verfahren einzuführen (mit den Kosten höherer Komplexität).
Prüfen wir noch, wie viele fehlende Werte es bei den vorhergesagten Werten gibt:
Da fehlende Werte u.U. mit dem Mittelwert (der übrigen prognostizierten Werte) aufgefüllt werden, erledigen wir das gleich, um den Effekt auf \(R^2\) abzuschätzen:
flights_test4_pred2 <-
flights_test4_pred %>%
mutate(pred_lm7 = replace_na(pred_lm7, mean(pred_lm7, na.rm = TRUE)))Keine fehlenden Werte mehr.
Wie sieht \(R^2\) jetzt aus?
flights_test4_pred2 %>%
  rsq(truth = dep_delay, estimate = pred_lm7)
Keine (nennenswerte) Veränderung.
370.22 Einreichen
Das beste Modell im Train-Sample reichen wir ein; in diesem Fall lm7.
submission_df <-
flights_test4_pred2 |>
select(id, pred = pred_lm7) # gleich umbenennen in "pred"write_csv(submission_df, file = "Sauer_Sebastian_0123456_Prognose.csv")370.23 Was noch?
370.23.1 Mehr geht immer…
Ein nächster Schritt könnte sein, sich folgende Punkte anzuschauen:
- Interaktionen
- Polynome
- Voraussetzungen
Eine Faustregel zu Interaktionen lautet: Wenn zwei Variablen jeweils einen starken Haupteffekt haben, lohnt es sich u.U., den Interaktionseffekt anzuschauen (vgl. Gelman & Hill, 2007, S. 69).
370.23.2 Tidymodels
Das ständige Updaten des Test-Datensatzes nervt; mit tidymodels wird es komfortabler und man hat Zugang zu leistungsfähigeren Prognosemodellen. Hier findet sich ein Einstieg und hier eine Fallstudie mit Tutorial.