Model Info:
 function:     stan_glm
 family:       gaussian [identity]
 formula:      len ~ supp
 algorithm:    sampling
 sample:       4000 (posterior sample size)
 priors:       see help('prior_summary')
 observations: 60
 predictors:   2

Estimates:
              mean   sd   10%   50%   90%
(Intercept) 20.7    1.4 18.9  20.7  22.4
suppVC      -3.7    2.0 -6.3  -3.7  -1.2
sigma        7.6    0.7  6.7   7.5   8.6

Fit Diagnostics:
           mean   sd   10%   50%   90%
mean_PPD 18.8    1.4 17.1  18.8  20.6

The mean_ppd is the sample average posterior predictive distribution of the outcome variable (for details see help('summary.stanreg')).

MCMC diagnostics
              mcse Rhat n_eff
(Intercept)   0.0  1.0  3935
suppVC        0.0  1.0  3654
sigma         0.0  1.0  3500
mean_PPD      0.0  1.0  3967
log-posterior 0.0  1.0  1995

For each parameter, mcse is Monte Carlo standard error, n_eff is a crude measure of effective sample size, and Rhat is the potential scale reduction factor on split chains (at convergence Rhat=1).pigs1
Question
Laden Sie den Datensatz toothgrowth, z.B. von dieser Quelle. In dem Datensatz sind die Daten eines einfaches Experiments berichtet.
Forschungsfrage:
Hat die Darreichungsform (supp, OJ vs. VC) einen (kausalen) Effekt auf die AV?
Berechnen Sie ein 95%-HDI für den Effekt!
Solution
- Schritt: Modell berechnen
Zur Erinnerung: Bei der Regressionsformel gilt immer av ~ uv.
- Schritt: Posteriori-Verteilung betrachten
Mit summary() kriegt man einen guten Überblick:
Aber man kann z.B. auch mit posterior_interval() sich sein Wunsch-Intervall ausgeben lassen:
                 2.5%       97.5%
(Intercept) 17.968137 23.33945238
suppVC      -7.614218  0.08866291
sigma        6.333723  9.18147661
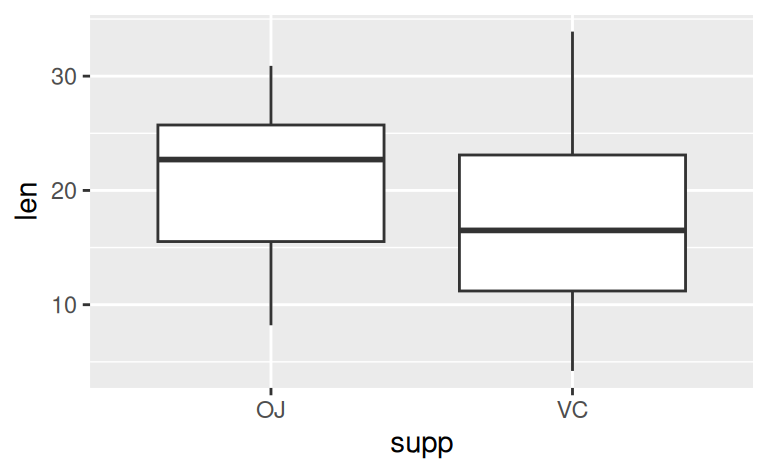
Schauen wir uns mal zum Vergleich die Stichproben-Daten an:
Aufgabenname: pigs1
Meta-information
exname: pigs1 extype: string expoints: 1 exsolution: NA exshuffle: false