---
title: kontingenztabelle1
date: '2026-07-14'
categories:
- paper
- todo
---

```{r libs, include = FALSE}

library(tidyverse)
library(mosaic)
library(knitr)
library(kableExtra)
```


```{r global-knitr-options, include=FALSE}
knitr::opts_chunk$set(fig.pos = 'H',
                      fig.asp = 0.618,
                      fig.width = 4,
                      fig.cap = "",
                      fig.path = "",
                      echo = FALSE)
```


Question
========

```{r defs, include=FALSE}
profs_set <- c("Süß", "Salzig", "Bitter", "Süß-Sauer")

prof_name <- sample(profs_set, 1)

n_set <- c(42, 50, 60, 70, 80, 90, 100)
n <- sample(n_set, 1)


erfolgsquote_weniglerner_set <- c(0.3, 0.35, 0.4, 0.45, 0.5)
erfolgsquote_weniglerner <- sample(erfolgsquote_weniglerner_set, 1)
zusatzerfolg_viellerner_set <- c(0.2, 0.25, 0.3, 0.35, 0.4)
zusatzerfolg_viellerner <- sample(zusatzerfolg_viellerner_set, 1)
erfolgsquote_viellerner <- erfolgsquote_weniglerner + zusatzerfolg_viellerner

# This is NOT what is asked for, that's the probability in the population:
unterschied_erfolgsquote <- erfolgsquote_viellerner - erfolgsquote_weniglerner

anteil_weniglerner_set <- c(.3, .4, .5, .6)
anteil_weniglerner <- sample(anteil_weniglerner_set, 1)


n_weniglerner <- floor(n * anteil_weniglerner)
n_viellerner <- n - n_weniglerner

Klausurergebnis <- c("Bestehen", "Durchfallen")
```


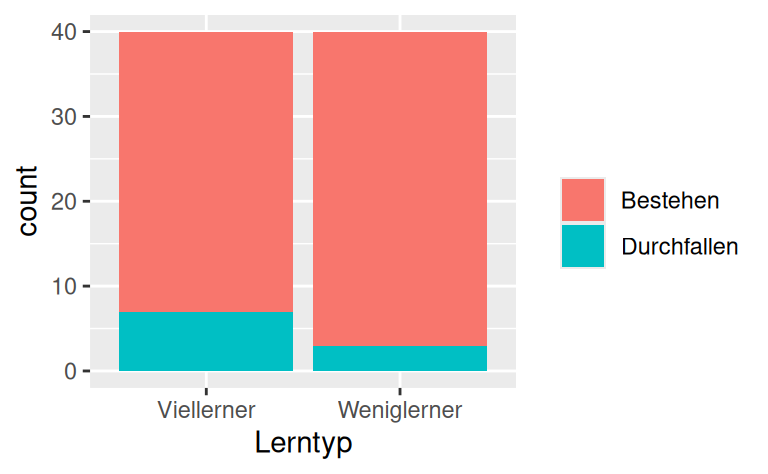
Prof. `r prof_name` untersucht eine seiner Lieblingsfragen: Wie viel bringt das Lernen auf eine Klausur? Dabei konzentriert er sich auf das Fach Statistik (es gefällt ihm gut). In einer aktuellen Untersuchung hat er $n=`r n`$ Studierende untersucht (s. Tabelle und Diagramm). Dabei hat er zwei Gruppen unterschieden: Die "Viel-Lerner" und die "Wenig-Lerner".

Berechnen Sie den Unterschied (als Anteil) im Lernerfolg ("Bestehen") zwischen den Gruppen!

*Beispiele*: Wenn Sie ausrechnen, dass der Unterschied im Lernerfolg 23 Prozentpunkte zugunsten der Viellerner beträgt, so geben Sie ein: `0.23`. Wenn Sie ausrechnen, dass der Unterschied im Lernerfolg 11 Prozentpunkte zugunsten der *Weniglerner* beträgt, so geben Sie zusätzlich ein Minuszeichen ein: `-0.11`.

*Hinweis*: Geben Sie *nur eine Zahl* ein (ohne Prozentzeichen o.Ä.), z.B. `0,20`. Andere Angaben können u.U. nicht gewertet werden. Runden Sie auf zwei Dezimalstellen. Beachten Sie das korrekte Dezimaltrennzeichen Ihres Systems (Punkt oder Komma).


```{r compute-table, results = "hold"}
d <-
  tibble(Lerntyp = c(rep("Weniglerner", times = n_weniglerner),
                     rep("Viellerner", times = n_viellerner))) %>%
  mutate(Lerntyp = factor(Lerntyp)) %>%
  mutate(Erfolg_p = case_when(
    Lerntyp == "Weniglerner" ~ erfolgsquote_viellerner,
    Lerntyp == "Viellerner" ~ erfolgsquote_viellerner,
    TRUE ~ NA_real_
  )) %>%
  mutate(Klausurergebnis = map_chr(.x = Erfolg_p,
                                .f = ~(sample(Klausurergebnis,
                                              size = 1,
                                              prob = c(.x, 1-.x)))))

mosaic::tally(Klausurergebnis ~ Lerntyp, data = d) %>%
  kbl(caption = "Ergebnisse der Studie") %>%
  kable_classic(full_width = F, html_font = "Cambria")

ggplot(d) +
  aes(x = Lerntyp, fill = factor(Klausurergebnis)) +
  geom_bar() +
  labs(fill = "")
```


```{r compute-rate-diff, echo =FALSE}
# THIS is what is asked for.

# "Bestehen" in favor of "Viellerner"
unterschied_bestehen_sample <- diffprop(Klausurergebnis ~ Lerntyp,
                                        data = d,
                                        success = "Bestehen")

# We need to swap the sign, because `diffprob` here computes `Weniglerner-Viellerner`
unterschied_bestehen_sample <- -unterschied_bestehen_sample

unterschied_bestehen_sample <- round(unterschied_bestehen_sample, 2)
```


Solution
========

Der Unterschied im Bestehen beträgt `r unterschied_bestehen_sample`


Aufgabenname: `kontingenztabelle1`


Meta-information
================
exname: kontingenztabelle1
extype: num
exsolution: `r unterschied_bestehen_sample`
extol: 0.05
expoints: 1