wo_men_path <- "https://raw.github.com/sebastiansauer/modar/master/datasets/wo_men.csv"
d <- read_csv(wo_men_path)hyp-women-06
Question
Der Datensatz wo_men Untersucht Geschlechtsunterschiede u.a. in Körpergröße.
Sie können ihn hier herunterladen:
Testen Sie anhand dieses Datensatzes folgende Hypothese \(H\):
“Männer sind im Schnitt größer als Frauen!”
Formaler:
\(d > 0\) mit \(d = \mu_M - \mu_F\).
Wenn man zwei Gruppen (zwei Populationen) vergleicht, kann man einfach den Unterschied in den Mittelwerten, \(d\), berechnen. Das macht meist Sinn, gerade wenn die Einheiten gut verständlich sind, wie es bei der Körpergröße der Fall ist. Bei einem psychometrischen Merkmal, sagen wir “Smartphone-Abhängigkeit”, das vielleicht auf einer Skale von 4 bis 44 gemessen wird, sind die Einheiten nicht wirklich gut interpretierbar. In diesem Fall macht man gerne Folgendes: Man berechnet den Mittelwertsunterschied und schaut dann, wie groß dieser Wert im Verhältnis zur Streuung (SD) der Variable ist.
Ein Beispiel zur Verdeutlichung: Der Unterschied \(d\) betrage 10cm. Die Streuung (sd) betrage 5cm. Dann ist der Unterschied genau zwei Streuungseinheiten.
Diesen Koeffizienten nennt man Cohens d.
Er ist so definiert:
\(C_d = \frac{d}{sd}\)
Anmerkung: Um die Streuung zu berechnen, gibt es ein paar Varianten. Meist nimmt man den Mittelwert der Streuungen (SDs) der beiden Grupppen, ungewichtet von der Gruppengröße. Das nennt man auch die “gepoolte SD” (pooled sd).
Nehmen Sie an: \(C_d = .5\).
Damit formulieren wir unsere Hypothese \(H\) neu:
\(H: C_d > .5\).
Das Unterschied in der mittleren Körpergröße soll also, laut \(H\), mindestens eine halbe SD-Einheit ausmachen.
Geben Sie an einen Schätzwert für \(C_d\) für obige Hypothese an! Nutzen Sie den Median der entsprechenden Post-Verteilung!
Solution
Betrachten wir zunächst die Daten:
d %>%
  ggplot(aes(x = height, fill = sex)) +
  geom_density()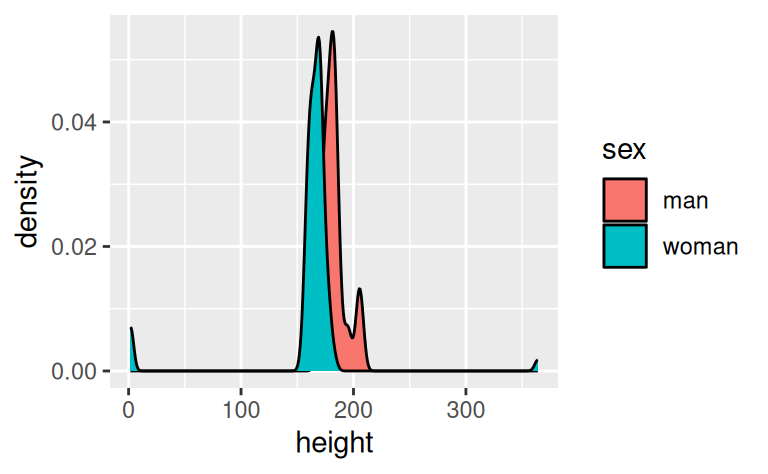
Wie man sieht, scheint es einige “komische” Werte zu geben. Besser wir entfernen diese vorab.
d2 <-
  d %>%
  filter(between(height, 150, 210))
Hat’s was gebracht?
d2 %>%
  ggplot(aes(x = height, fill = sex)) +
  geom_density()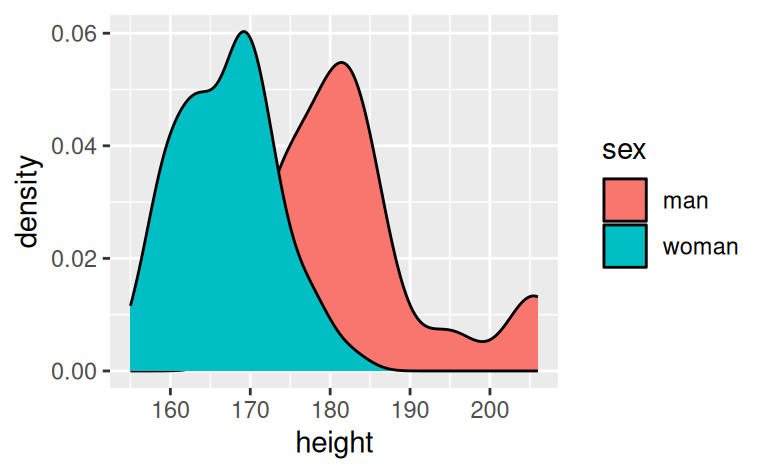
Naja, einigermaßen besser.
lm2 <- stan_glm(height ~ sex, data = d2, refresh = 0)lm2_post <-
lm2 %>%
as_tibble()
lm2_post %>%
slice_head(n=5)| (Intercept) | sexwoman | sigma |
|---|---|---|
| 183.0108 | -16.97838 | 6.927483 |
| 182.3098 | -15.47314 | 7.016502 |
| 182.2224 | -14.80622 | 7.512152 |
| 183.5662 | -17.36896 | 6.643356 |
| 184.3611 | -18.29729 | 7.100470 |
Da die meisten Funktionen aus rstanarm keine Tabellen zurückliefern, aber mit as_tibble() leicht in eine Tabelle (ein “Tibble”) umgewandelt werden können, haben wir das hier (und an anderen Stellen) gemacht.
Jetzt noch ein kleines (vielleicht nerviges) Detail: Wir berechnen wir noch die gepoolte SD, \(sd_p\), also den Mittelwert der Streuung in den beiden Geschlechtern:
d2 %>%
  group_by(sex) %>%
summarise(height_sd = sd(height))| sex | height_sd |
|---|---|
| man | 9.958082 |
| woman | 6.105615 |
Also:
sd_m = 9.96
sd_f = 6.11
Die gepoolte Varianz berechnet sich dann so:
sd_pooled = sqrt((sd_m^2 + sd_f^2) / 2)
sd_pooled
[1] 8.262376Also etwa der Mittelwert von sd_m und sd_f.
Jetzt können wir $C_d` berechnen.
Zur Errinerung: Die Differenz zwischen den Gruppen wird durch die Spalte sexwoman angegeben:
lm2_post %>%
slice_head(n=2)| (Intercept) | sexwoman | sigma |
|---|---|---|
| 183.0108 | -16.97838 | 6.927483 |
| 182.3098 | -15.47314 | 7.016502 |
lm2_post <-
  lm2_post %>%
  mutate(Cohens_d = sexwoman / sd_pooled)
Hier ist die Verteilung von \(C_d\):
lm2_post %>%
  ggplot(aes(x = Cohens_d)) +
  geom_density()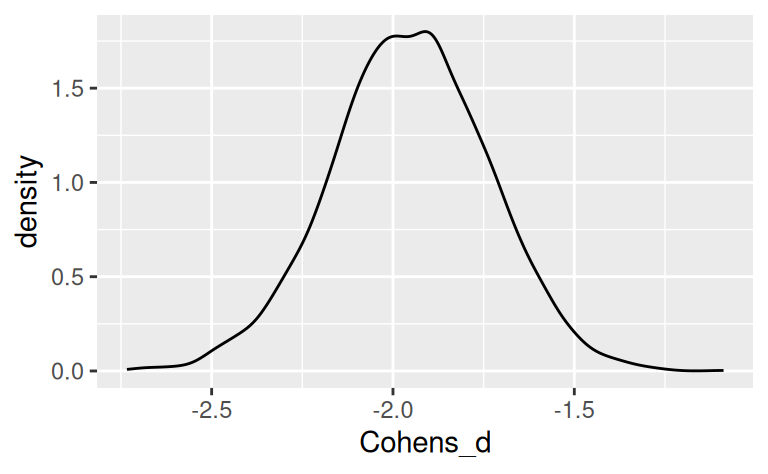
Gefragt war nach dem Median:
lm2_post %>%
summarise(Cohens_d_md = median(Cohens_d))| Cohens_d_md |
|---|
| -1.953187 |
Der mittlere Größenunterschied beträgt also ca. 2 SD-Einheiten.
Das ist mal ein superstarker Effekt. Die allermeisten Effekte, die man in der Psychologie findet, sind viel kleiner.
Merken Sie sich mal diesen Wert von \(C_d\), als Vergleich, wenn Sie andere Werte von sehen.
Die Antwort (solution, sol) lautet also, laut diesem Modell (mit gegebener Simulationsvarianz):
sol <- -1.95
sol
[1] -1.95Aufgabenname: hyp-women-06
Meta-information
exname: hyp-women-06 extype: num exsolution: -1.95 extol: .2 expoints: 1