wo_men_path <- "https://raw.github.com/sebastiansauer/modar/master/datasets/wo_men.csv"
d <- read_csv(wo_men_path)hyp-women-01
Question
Der Datensatz wo_men Untersucht Geschlechtsunterschiede u.a. in Körpergröße.
Sie können ihn hier herunterladen:
Testen Sie anhand dieses Datensatzes folgende Hypothese:
“Männer sind im Schnitt größer als Frauen!”
Präziser formuliert:
\(\mu_M > \mu_F\), wobei \(\mu\) den Mittelwert angibt (in der Population, auch Erwartungswert genannt).
Geben Sie als Lösung an, welcher Anteil der Postverteilung einen höheren Mittelwert zugunsten der Männer aufweist!
Solution
lm1 <- stan_glm(height ~ sex, data = d, refresh = 0)Schauen wir uns die Post-Verteilung an:
lm1_post <-
  lm1 %>%
as_tibble()library(bayesplot)
mcmc_areas(lm1, pars = "sexwoman")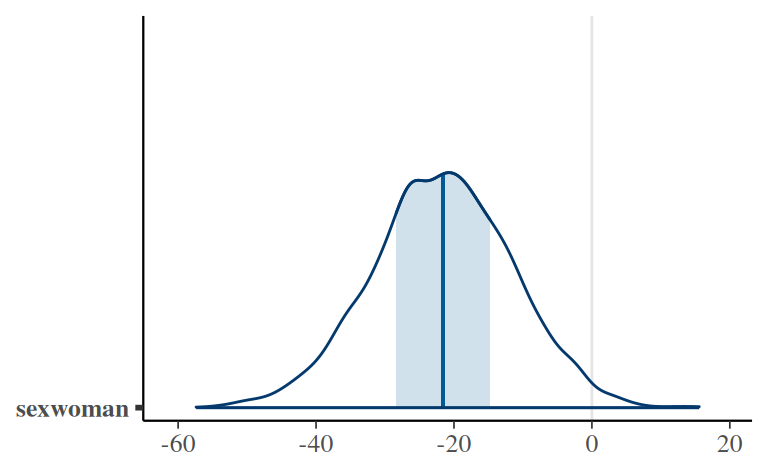
Wie man sieht ist die Verteilung des Mittelwertsunterschieds ziemlich eindeutig: Nur mit geringer Wahrscheinlichkeit geht das Modell davon aus, dass Frauen einen höheren Mittelwert (in der Population) aufweisen als Männer. Mit hoher Gewissheit geht das Modell davon aus, dass Männer einen höheren Mittelwert aufweisen (als Frauen).
Lassen wir uns den genauen Anteil ausgeben:
lm1_post %>%
count(sexwoman < 0) | sexwoman < 0 | n |
|---|---|
| FALSE | 53 |
| TRUE | 3947 |
Rechnen wir den Anteil noch aus:
prop_maenner_schwerer_df <-
  lm1_post %>%
  count(sexwoman < 0) %>%
  mutate(prop = n/sum(n))

prop_maenner_schwerer_df| sexwoman < 0 | n | prop |
|---|---|---|
| FALSE | 53 | 0.01325 |
| TRUE | 3947 | 0.98675 |
Die Antwort lautet also, laut diesem Modell (mit gegebener Simulationsvarianz):
prop_maenner_schwerer <- prop_maenner_schwerer_df %>%
  pull(prop)

sol <- prop_maenner_schwerer[2]
sol
[1] 0.98675Wir resümieren: Die Wahrscheinlichkeit, dass \(\mu_M > \mu_F\) liegt bei 0.99, laut unserem Modell.
Aufgabenname: hyp-women-01
Meta-information
exname: hyp-women-01 extype: num exsolution: 0.98675 exshuffle: false extol: .05 expoints: 1