Pr_g[1] 0.01
Pr_t_geg_g[1] 0.9
August 6, 2026
Wissenschaft! Vielleicht das wichtigste Projekt der Menschheit, geht es doch um die Loslöung von “Du musst das glauben, weil ich es sage” hin zu “Ich glaube das, weil ich es verstehe”.
Sei 1% aller Studien der Wissenschaft “genial”. Ein Gutachter prüft eine wissenschaftliche Studie und erkennt 90% der genialen Studien als solche. Allerdings stuft der Gutachter auch 10% der nicht-genialen Studien fälschlich als genial ein. Nach der Prüfung der Studie ist der Gutachter überzeugt, dass die Studie genial ist.
Aufgabe: Berechnen Sie die Wahrscheinlichkeit, dass die Studie wirklich genial ist.
Gegeben ist:
Hier kann man Bayes’ Theorem anwenden:
\(Pr(g|t) = \frac{Pr(g) \cdot Pr(t|g) }{Pr(t)}\).
Zähler: 0.009
Nenner: 0.108
Bruch: 0.0833333
Die Lösung beträgt also: 0.08.
Hier ist ein Baumdiagramm zur Visualisierung:
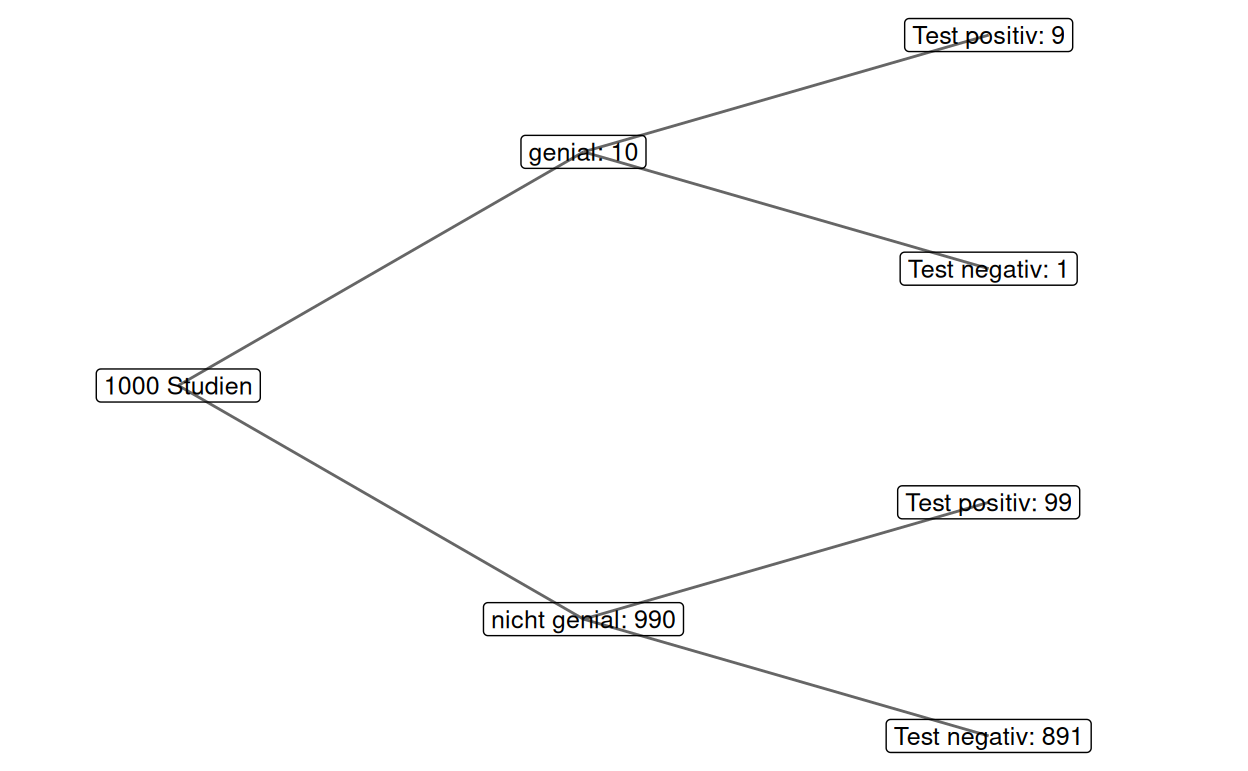
Es erhalten 108=99+9 Studien ein positives Testergebnis: “geniale Studie!” Davon sind 9 tatsächlich genial. Das ist ist ein Anteil von \(\frac{9}{108} = 0.0833\).
Also: \(Pr(g|t) = \frac{9}{108} = 0.0833\).
Alternativ kann man auch mit der Bayesbox arbeiten:
| Hypothese | Prior | Likelihood | Post_unstand | Evidenz | Post |
|---|---|---|---|---|---|
| genial | .01 | .9 | .009 | .108 | .083 |
| nichtgenial | .99 | .1 | .099 | .108 | .092 |
Die Likelihood für die Hypothese \(g\) (die Hypothese, dass die Studie genial ist) ist definiert als \(Pr(D|H)=.9\). Hier entspricht der positive Genialitätstest den Daten.
Die unstandardisierte Post-Wahrscheinlichkeit entspricht dem Produkt aus Likelihood und Prior: \(Pr(D|H) \cdot Pr(H)=.009\) bzw. \(.099\).
Die Evidenz ist die Summe der Posterior-Wahrscheinlichkeiten multipliziert mit den jeweiligen Priors: \(Pr(D)=.108\).
Die Post-Wahrscheinlichkeit ist die durch die Evidenz dividierte unstandardisierte Post-Wahrscheinlichkeit: \(Pr(H|D)= .009 / .108 = .083\) (bzw. für “nicht-genial”: \(.917\)).
Die Distraktoren entstehen durch typische Bayes-Fehler: Verwechslung mit der Likelihood \(Pr(t|g)=0.9\) (Base-Rate-Neglect), Verwechslung mit dem Prior \(Pr(g)=0.01\), das Komplement \(1-Pr(g|t)\), sowie die falsch-positiv-Rate \(1-Pr(t|g)=0.1\).
Aufgabenname: genial-schoice
exname: genial-schoice extype: schoice expoints: 1 exsolution: 10000 exshuffle: 5
---
title: genial-schoice
date: '2026-08-06'
categories:
- paper
- todo
---
```{r libs, include = FALSE}
library(tidyverse)
library(exams)
```
```{r global-knitr-options, include=FALSE}
knitr::opts_chunk$set(fig.pos = 'H',
fig.asp = 0.618,
fig.width = 4,
fig.cap = "",
fig.path = "",
echo = TRUE,
message = FALSE,
warning = FALSE,
fig.show = "hold",
cache = TRUE)
```
```{r compute, include=FALSE}
Pr_g <- 0.01 # Anteil genialer Studien/ Wskt einer *g*enialen Studie
Pr_t_geg_g <- 0.9 # Wskt, dass eine Studie als genial getestet wird gegeben, dass sie genial ist
zaehler_bayes <- Pr_g * Pr_t_geg_g
nenner_bayes <- (zaehler_bayes + (1-Pr_g) * (1-Pr_t_geg_g))
sol <- zaehler_bayes / nenner_bayes
```
Question
========
Wissenschaft! Vielleicht das wichtigste Projekt der Menschheit, geht es doch um die Loslöung von "Du musst das glauben, weil ich es sage" hin zu "Ich glaube das, weil ich es verstehe".
Sei 1% aller Studien der Wissenschaft "genial". Ein Gutachter prüft eine wissenschaftliche Studie und erkennt 90% der genialen Studien als solche.
Allerdings stuft der Gutachter auch 10% der nicht-genialen Studien fälschlich als genial ein.
Nach der Prüfung der Studie ist der Gutachter überzeugt, dass die Studie genial ist.
*Aufgabe*: Berechnen Sie die Wahrscheinlichkeit, dass die Studie wirklich genial ist.
Answerlist
----------
* `r round(sol, 2)`
* `r round(Pr_t_geg_g, 2)`
* `r round(Pr_g, 2)`
* `r round(1 - sol, 2)`
* `r round(1 - Pr_t_geg_g, 2)`
Solution
========
Gegeben ist:
```{r}
Pr_g
Pr_t_geg_g
```
Hier kann man Bayes' Theorem anwenden:
$Pr(g|t) = \frac{Pr(g) \cdot Pr(t|g) }{Pr(t)}$.
Zähler: `r zaehler_bayes`
Nenner: `r nenner_bayes`
Bruch: `r sol`
Die Lösung beträgt also: `r round(sol, 2)`.
Hier ist ein Baumdiagramm zur Visualisierung:
```{r baumdiagramm, echo=FALSE, fig.width=6.5, fig.height=4, fig.cap="", echo=FALSE}
N <- 1000
Pr_t_geg_nicht_g <- 1 - Pr_t_geg_g # Falsch-Positiv-Rate: 10 %
n_g <- N * Pr_g
n_nicht_g <- N * (1 - Pr_g)
n_g_t <- n_g * Pr_t_geg_g
n_g_nt <- n_g - n_g_t
n_ng_t <- n_nicht_g * Pr_t_geg_nicht_g
n_ng_nt <- n_nicht_g - n_ng_t
knoten <- data.frame(
x = c(0, 1, 1, 2, 2, 2, 2),
y = c(0, 1, -1, 1.5, 0.5, -0.5, -1.5),
label = c(
paste0(N, " Studien"),
paste0("genial: ", n_g),
paste0("nicht genial: ", n_nicht_g),
paste0("Test positiv: ", n_g_t),
paste0("Test negativ: ", n_g_nt),
paste0("Test positiv: ", n_ng_t),
paste0("Test negativ: ", n_ng_nt)
)
)
kanten <- data.frame(
x = c(0, 0, 1, 1, 1, 1),
y = c(0, 0, 1, 1, -1, -1),
xend = c(1, 1, 2, 2, 2, 2),
yend = c(1, -1, 1.5, 0.5, -0.5, -1.5)
)
ggplot() +
geom_segment(data = kanten, aes(x = x, y = y, xend = xend, yend = yend),
color = "grey40") +
geom_label(data = knoten, aes(x = x, y = y, label = label), size = 3.3) +
theme_void() +
xlim(-0.3, 2.5)
```
Es erhalten 108=99+9 Studien ein positives Testergebnis: "geniale Studie!" Davon sind 9 tatsächlich genial. Das ist ist ein Anteil von $\frac{9}{108} = 0.0833$.
Also: $Pr(g|t) = \frac{9}{108} = 0.0833$.
Alternativ kann man auch mit der Bayesbox arbeiten:
| Hypothese | Prior | Likelihood | Post_unstand | Evidenz | Post |
|----------- |-------|------------|--------------|---------|------|
| genial | .01 | .9 | .009 | .108 | .083 |
| nichtgenial | .99 | .1 | .099 | .108 | .092 |
Die Likelihood für die Hypothese $g$ (die Hypothese, dass die Studie genial ist) ist definiert als $Pr(D|H)=.9$.
Hier entspricht der positive Genialitätstest den Daten.
Die unstandardisierte Post-Wahrscheinlichkeit entspricht dem Produkt aus Likelihood und Prior: $Pr(D|H) \cdot Pr(H)=.009$ bzw. $.099$.
Die Evidenz ist die Summe der Posterior-Wahrscheinlichkeiten multipliziert mit den jeweiligen Priors: $Pr(D)=.108$.
Die Post-Wahrscheinlichkeit ist die durch die Evidenz dividierte unstandardisierte Post-Wahrscheinlichkeit: $Pr(H|D)= .009 / .108 = .083$ (bzw. für "nicht-genial": $.917$).
Die Distraktoren entstehen durch typische Bayes-Fehler:
Verwechslung mit der Likelihood $Pr(t|g)=0.9$ (Base-Rate-Neglect),
Verwechslung mit dem Prior $Pr(g)=0.01$, das Komplement $1-Pr(g|t)$, sowie die falsch-positiv-Rate $1-Pr(t|g)=0.1$.
Aufgabenname: `genial-schoice`
Answerlist
----------
* True
* False
* False
* False
* False
Meta-information
================
exname: genial-schoice
extype: schoice
expoints: 1
exsolution: 10000
exshuffle: 5