---
title: gem-wskt1-schoice-fix
date: '2026-08-06'
categories:
- paper
- todo
---

```{r libs, include = FALSE}
library(tidyverse)
library(mosaic)
library(knitr)
library(gt)
```

```{r global-knitr-options, include=FALSE}
knitr::opts_chunk$set(fig.pos = 'H',
                      fig.asp = 0.618,
                      fig.width = 4,
                      fig.cap = "",
                      fig.path = "",
                      echo = FALSE)
```

```{r data generation, include=FALSE}
Klausurergebnis <- c("Bestehen", "Durchfallen")
Lerntypen <- c("Viellerner", "Weniglerner")

ok <- FALSE
while (!ok) {
  prof_name <- sample(c("Süß", "Salzig", "Bitter", "Süß-Sauer"), 1)

  sample_size <- sample(c(42, 50, 60, 70, 80, 90, 100), 1)

  erfolgsquote_weniglerner <- sample(c(0.3, 0.35, 0.4, 0.45, 0.5), 1)
  zusatzerfolg_viellerner  <- sample(c(0.2, 0.25, 0.3, 0.35, 0.4), 1)
  erfolgsquote_viellerner  <- erfolgsquote_weniglerner + zusatzerfolg_viellerner

  anteil_weniglerner <- sample(c(.3, .4, .5, .6), 1)
  n_weniglerner <- floor(sample_size * anteil_weniglerner)
  n_viellerner  <- sample_size - n_weniglerner

  # Zellenhäufigkeiten deterministisch aus den Erfolgsquoten ableiten
  # (keine Pro-Person-Simulation, damit die Tabelle exakt zu den
  # genannten Wahrscheinlichkeiten passt)
  n_weniglerner_bestehen    <- round(n_weniglerner * erfolgsquote_weniglerner)
  n_weniglerner_durchfallen <- n_weniglerner - n_weniglerner_bestehen
  n_viellerner_bestehen     <- round(n_viellerner * erfolgsquote_viellerner)
  n_viellerner_durchfallen  <- n_viellerner - n_viellerner_bestehen

  Klausurergebnis_selected <- sample(Klausurergebnis, 1)
  Klausurergebnis_other    <- setdiff(Klausurergebnis, Klausurergebnis_selected)
  Lerntyp_selected <- sample(Lerntypen, 1)
  Lerntyp_other    <- setdiff(Lerntypen, Lerntyp_selected)

  probs_sample <- tibble::tribble(
    ~Lerntyp,      ~Klausurergebnis, ~n,
    "Weniglerner", "Bestehen",       n_weniglerner_bestehen,
    "Weniglerner", "Durchfallen",    n_weniglerner_durchfallen,
    "Viellerner",  "Bestehen",       n_viellerner_bestehen,
    "Viellerner",  "Durchfallen",    n_viellerner_durchfallen
  ) %>%
    group_by(Lerntyp) %>%
    mutate(n_group = sum(n)) %>%
    ungroup() %>%
    mutate(prop_conditional_group = n / n_group,
           joint_prob = n / sample_size)

  sol <- probs_sample %>%
    filter(Lerntyp == Lerntyp_selected, Klausurergebnis == Klausurergebnis_selected) %>%
    pull(joint_prob) %>%
    round(2)

  dist_conditional <- probs_sample %>%
    filter(Lerntyp == Lerntyp_selected, Klausurergebnis == Klausurergebnis_selected) %>%
    pull(prop_conditional_group) %>%
    round(2)

  dist_joint_other_outcome <- probs_sample %>%
    filter(Lerntyp == Lerntyp_selected, Klausurergebnis == Klausurergebnis_other) %>%
    pull(joint_prob) %>%
    round(2)

  dist_joint_other_group <- probs_sample %>%
    filter(Lerntyp == Lerntyp_other, Klausurergebnis == Klausurergebnis_selected) %>%
    pull(joint_prob) %>%
    round(2)

  dist_complement <- round(1 - sol, 2)

  antworten <- c(sol, dist_conditional, dist_joint_other_outcome,
                 dist_joint_other_group, dist_complement)

  # Nur akzeptieren, wenn alle 5 Antwortoptionen paarweise verschieden
  # sind und keine trivialen Randwerte (0 bzw. 1) auftreten
  ok <- length(unique(antworten)) == 5 &&
    all(antworten > 0) &&
    all(antworten < 1)
}

d <-
  tibble(
    Lerntyp = c(
      rep("Weniglerner", times = n_weniglerner),
      rep("Viellerner",  times = n_viellerner)
    ),
    Klausurergebnis = c(
      rep("Bestehen",    times = n_weniglerner_bestehen),
      rep("Durchfallen", times = n_weniglerner_durchfallen),
      rep("Bestehen",    times = n_viellerner_bestehen),
      rep("Durchfallen", times = n_viellerner_durchfallen)
    )
  ) %>%
  mutate(Lerntyp = factor(Lerntyp, levels = Lerntypen))
```


Question
========
Prof. `r prof_name` untersucht eine seiner Lieblingsfragen: Wie viel bringt das Lernen auf eine Klausur?
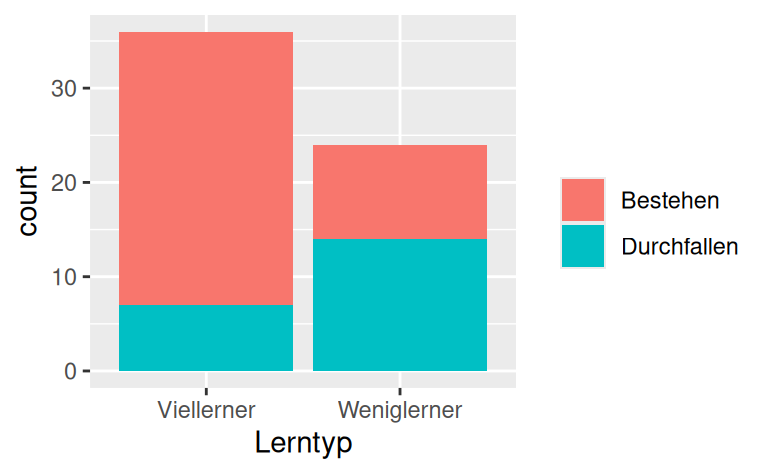
Dabei konzentriert er sich auf das Fach Statistik (es gefällt ihm gut). In einer aktuellen Untersuchung hat er $n=`r sample_size`$ Studierende untersucht (s. Tabelle und Diagramm) und jeweils erfasst,
ob die Person die Klausur bestanden ($B$) hat oder durchgefallen ($\neg B$) ist.
Im Hinblick auf das Lernen, $L$ (wie viel die Person gelernt hat) hat er zwei Gruppen unterschieden: Die "Viel-Lerner" (VL) und die "Wenig-Lerner" (WL).


Das folgende Diagramm zeigt die Häufigkeiten pro Gruppe:

```{r plot-bars, echo=FALSE}
ggplot(d) +
  aes(x = Lerntyp, fill = factor(Klausurergebnis)) +
  geom_bar() +
  labs(fill = "")
```

Hier ist die Kontingenztabelle mit den Häufigkeiten pro Gruppe:

```{r print-tab, echo=FALSE}
probs_sample %>%
  select(Lerntyp, Klausurergebnis, n) %>%
  pivot_wider(names_from = Klausurergebnis,
          values_from = n) %>%
  kable()
```

*Berechnen Sie die folgende *gemeinsame Wahrscheinlichkeit*: p(`r Klausurergebnis_selected` UND `r Lerntyp_selected`). Wählen Sie die richtige Antwortoption.*


Answerlist
----------
* `r sol`
* `r dist_conditional`
* `r dist_joint_other_outcome`
* `r dist_joint_other_group`
* `r dist_complement`


Solution
========
Die gemeinsame Wahrscheinlichkeit berechnet sich als der Quotient der Zellenhäufigkeit und der Gesamthäufigkeit:

$Pr(`r Klausurergebnis_selected` \cap `r Lerntyp_selected`) = \frac{n(`r Klausurergebnis_selected` \cap `r Lerntyp_selected`)}{n_{gesamt}} = \frac{`r probs_sample %>% filter(Lerntyp == Lerntyp_selected, Klausurergebnis == Klausurergebnis_selected) %>% pull(n)`}{`r sample_size`} = `r sol`$

Die falschen Optionen entstehen durch typische Verwechslungen: die bedingte statt der gemeinsamen Wahrscheinlichkeit, die gemeinsame Wahrscheinlichkeit des jeweils anderen Klausurergebnisses bzw. der anderen Lerngruppe, sowie das naive Komplement (1 − Lösung).


Aufgabenname: `gem-wskt1-schoice-fix`


Answerlist
----------
* True
* False
* False
* False
* False


Meta-information
================
exname: gem-wskt1-schoice-fix
extype: schoice
expoints: 1
exsolution: 10000
exshuffle: 5