d_path <- "https://raw.githubusercontent.com/avehtari/ROS-Examples/master/Arsenic/data/wells.csv"

d <- read_csv(d_path)bangladesh2
paper
todo
Question
Eine Studie untersuchte den Arsengehalt arsenic in Brunnen in Bangladesh. Die Forschis untersuchten u.a., ob die Menschen bereit waren, auf einen Brunnen zu wechseln switch, der nicht mit Arsen belastet war, und welche Rolle die Entfernung (in Einheiten von 100 Meter, dist100) zum nächsten unbelasteten Brunnen spielt.
Die Daten sind hier zu beziehen:
Hier ist ein Regressionsmodell mit Interaktionseffekt:
m2 <- stan_glm(switch ~ dist100 + arsenic + dist100:arsenic,
               family = binomial(link = "logit"),
               data = d,
refresh = 0)print(m2, digits = 2)stan_glm
family: binomial [logit]
formula: switch ~ dist100 + arsenic + dist100:arsenic
observations: 3020
predictors: 4
------
Median MAD_SD
(Intercept) -0.15 0.12
dist100 -0.59 0.20
arsenic 0.56 0.07
dist100:arsenic -0.18 0.10
------
* For help interpreting the printed output see ?print.stanreg
* For info on the priors used see ?prior_summary.stanregUnd hier das Modell mit gleichen Prädiktoren, aber zentrierten Prädiktoren:
d2 <-
  d %>%
  select(dist100, arsenic, switch) %>%
  drop_na() %>%
  mutate(dist100_c = dist100 - mean(dist100),
         arsenic_c = arsenic - mean(arsenic))

m3 <- stan_glm(switch ~ dist100_c + arsenic_c + dist100_c:arsenic_c,
               family = binomial(link = "logit"),
               data = d2,
refresh = 0)print(m3, digits = 2)stan_glm
family: binomial [logit]
formula: switch ~ dist100_c + arsenic_c + dist100_c:arsenic_c
observations: 3020
predictors: 4
------
Median MAD_SD
(Intercept) 0.35 0.04
dist100_c -0.88 0.11
arsenic_c 0.47 0.04
dist100_c:arsenic_c -0.18 0.10
------
* For help interpreting the printed output see ?print.stanreg
* For info on the priors used see ?prior_summary.stanregWarum hat das nicht zentrierte Modell größere Standardfehler (MAD_sd)?
Solution
Der Hauptgrund ist, dass im Modell m2, dem Modell mit unzentrierten Prädiktoren, eine hohe Korrelation zwischen einfachen Prädiktoren und dem Interaktionsterm vorliegt. Hohe Korrelation zwischen den Prädiktoren erhöht die Standardfehler. Warum ist das so? Sind zwei Prädiktoren hoch korreliert, was ist dann der Mehrwert, den zweiten Prädiktor zu kennen, wenn man den ersten kennt? Gering, vermutlich! Denn der zweite birgt ja redundante Information im Vergleich zum ersten. Aber das Modell könnte auch denken, dass der zweite Prädiktor wichtig und der erste redundant ist. Kurz gesagt: Das Modell ist verwirrt. Das schlägt sich in höheren Standardfehlern nieder. Durch das Zentrieren wird die Korrelation zwischen den einfachen Prädiktoren und dem Interaktionsterm aufgelöst bzw. zumindest deutlich verringert.
Zur Verdeutlichung: Die Korrelation zwischen einfachen Prädiktoren und Interaktionsterm:
library(corrr)
d %>%
  select(dist100, switch, arsenic) %>%
  mutate(dist100xarsenic = dist100 * arsenic) %>%
correlate() | term | dist100 | switch | arsenic | dist100xarsenic |
|---|---|---|---|---|
| dist100 | NA | -0.1179417 | 0.1780577 | 0.7722562 |
| switch | -0.1179417 | NA | 0.1838683 | 0.0075759 |
| arsenic | 0.1780577 | 0.1838683 | NA | 0.6350426 |
| dist100xarsenic | 0.7722562 | 0.0075759 | 0.6350426 | NA |
Wie man sieht, ist die Korrelation hoch.
Jetzt zum Vergleich die zentrierten Daten:
d2 %>%
  select(dist100_c, switch, arsenic_c) %>%
  mutate(dist100_cxarsenic_c = dist100_c * arsenic_c) %>%
correlate() | term | dist100_c | switch | arsenic_c | dist100_cxarsenic_c |
|---|---|---|---|---|
| dist100_c | NA | -0.1179417 | 0.1780577 | 0.1846823 |
| switch | -0.1179417 | NA | 0.1838683 | -0.0372922 |
| arsenic_c | 0.1780577 | 0.1838683 | NA | 0.0393920 |
| dist100_cxarsenic_c | 0.1846823 | -0.0372922 | 0.0393920 | NA |
Dieses Phänomen bezeichnet man auch Kollinearität.
Weitere Erklärung findet sich bei McElreath 2020, Kap. 6 oder z.B. hier.
Ein ergänzender Blick auf die Korrelationen der Prädiktoren:
Korrelationen der Koeffizienten für m2:
library(bayesplot)
mcmc_pairs(m2)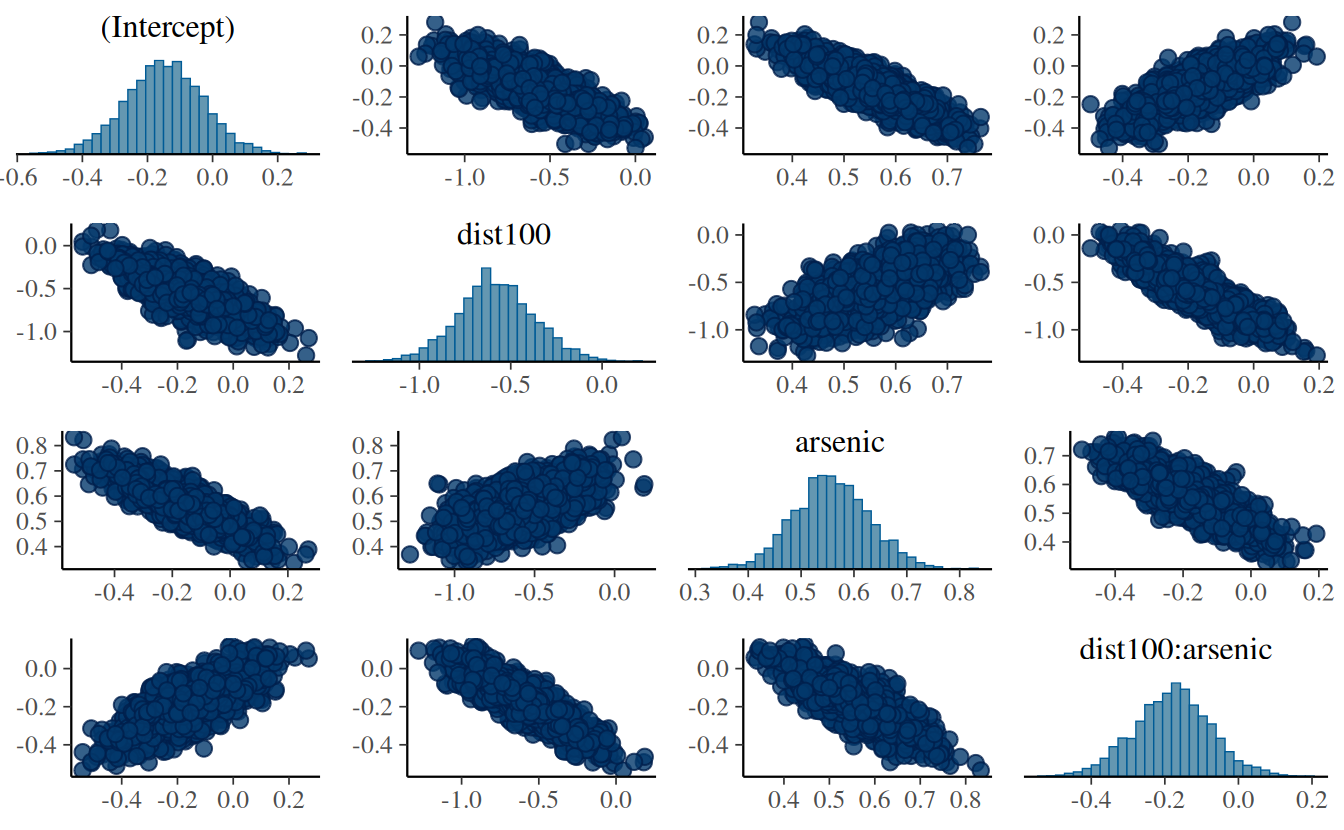
Korrelationen der Koeffizienten für m3:
library(bayesplot)
mcmc_pairs(m3)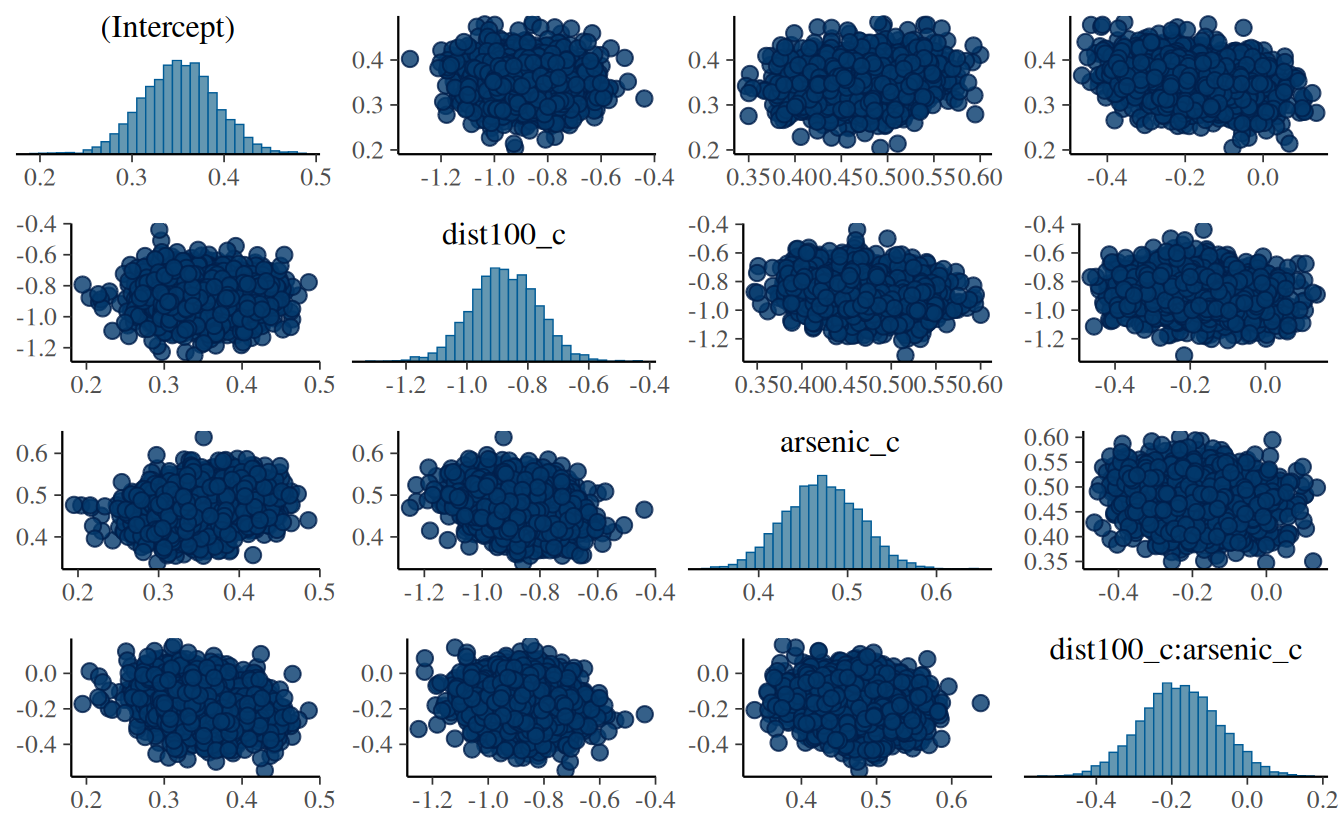
Ein zweiter, weniger wichtiger Grund für die Reduktion der Standardfehler ist der Folgende.
Liegt der Achsenabschnitt (Intercept, Konstante des Modells) am Rand der Daten, so ist seine Ungewissheit größer, als wenn er in der Mitte der Daten liegt:
d2 %>%
  ggplot(aes(x = dist100, y = switch)) +
  geom_point() +
  geom_smooth(method = "lm") +
  labs(title = "dist100, unzentriert",
       subtitle = "höherer Standardfehler im Achsenabschnitt")


d2 %>%
  ggplot(aes(x = dist100_c, y = switch)) +
  geom_point() +
  geom_smooth(method = "lm") +
  labs(title = "dist100_c, zentriert",
       subtitle = "geringerer Standardfehler im Achsenabschnitt")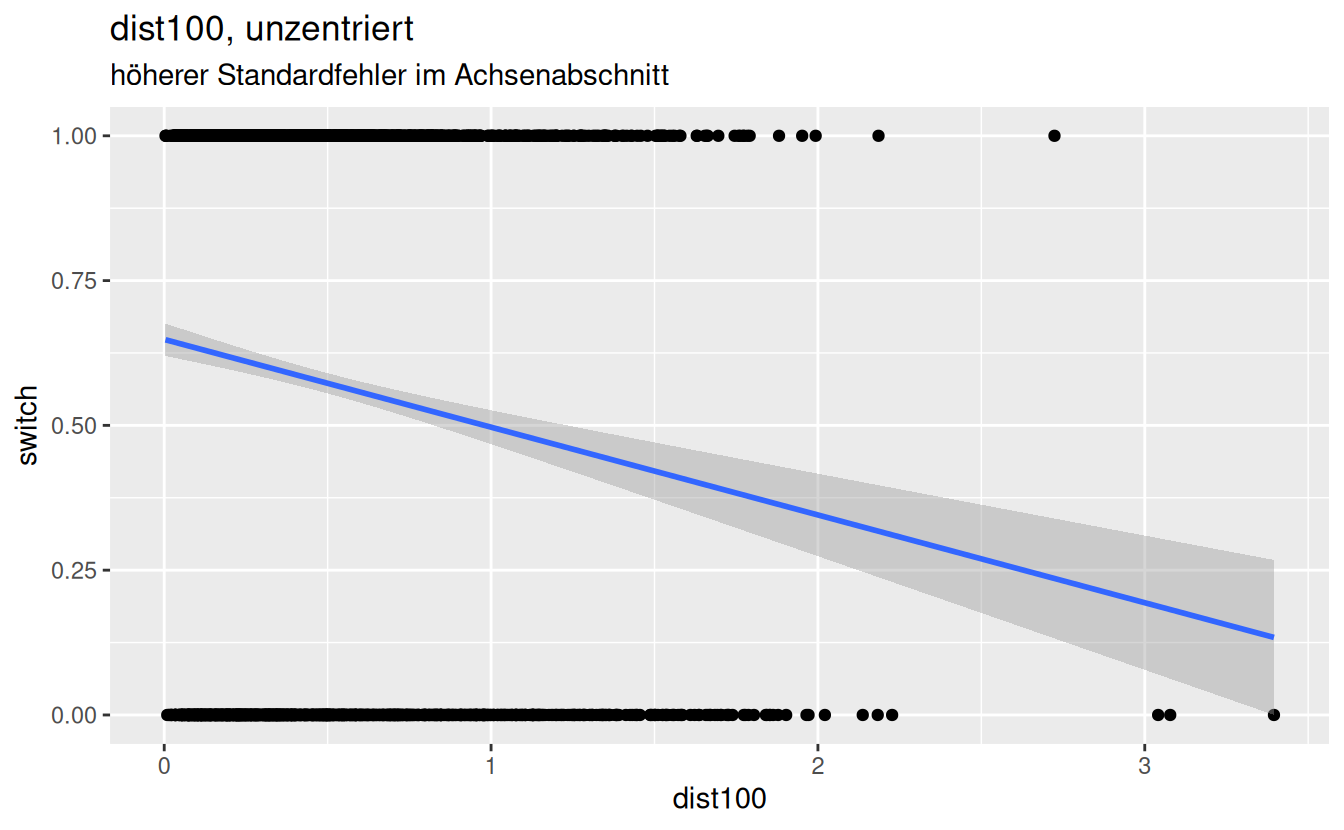
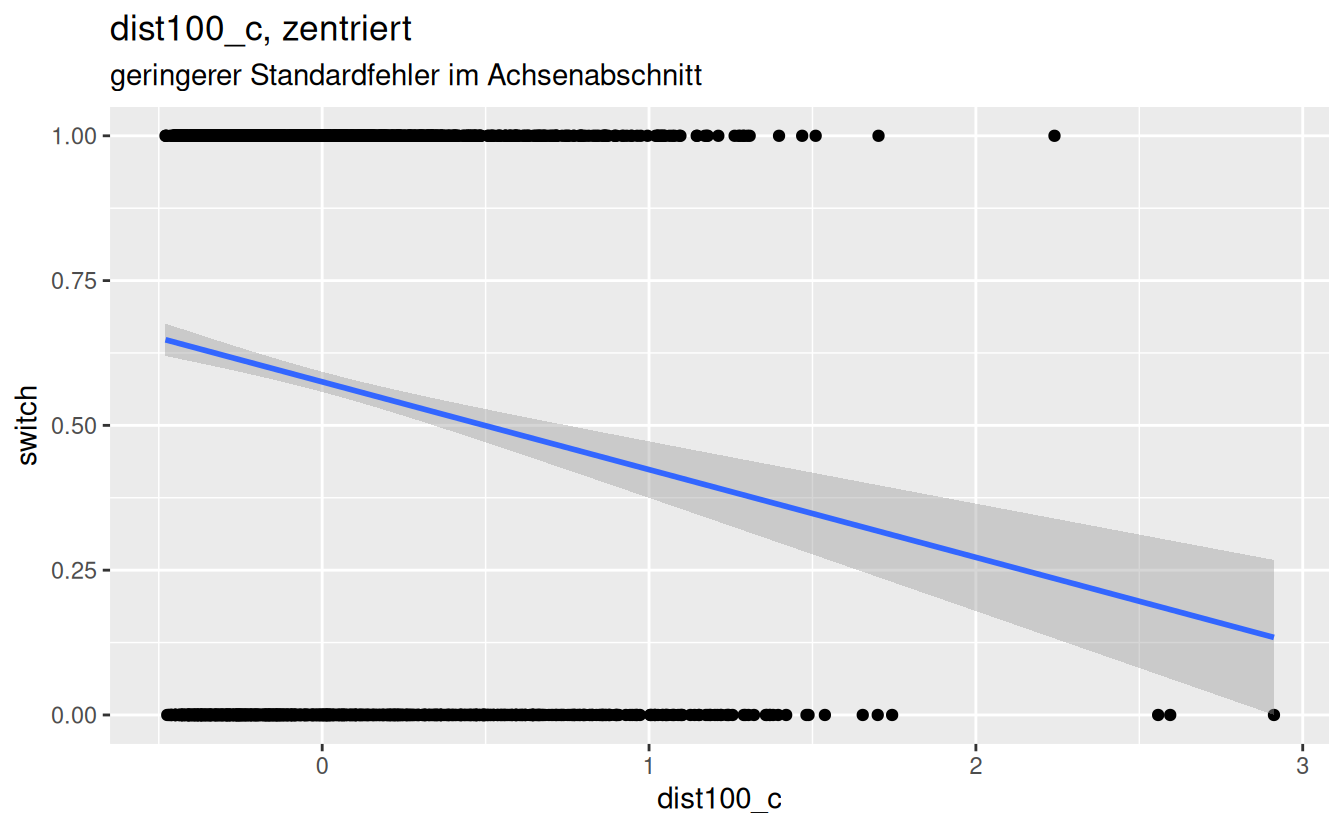
Der Effekt ist allerdings nicht groß.
Auch für ein generalisiertes lineares Modell (wie die logistische Regression) gilt dieser Grundsatz: An den Rändern der Daten (minimales bzw. maximale Prädiktorwerte) sind die Schätzungen ungenauer als im Zentrum.
library(tidybayes)
library(modelr)
d3 <-
d2 %>%
  mutate(arsenic_bin = ifelse(arsenic < median(arsenic), 1, 0))


m4 <- stan_glm(switch ~ dist100_c + arsenic_bin + dist100_c:arsenic_bin,
               family = binomial(link = "logit"),
               data = d3,
               refresh = 0)


d4 <-
  d3 %>%
  group_by(arsenic_bin) %>%
  data_grid(dist100_c = seq_range(dist100_c, n = 20)) %>%
  add_epred_draws(m4)

d4 %>%
  ggplot(aes(x = dist100_c, y = switch, color = ordered(arsenic_bin))) +
  stat_lineribbon(aes(y = .epred)) +
  geom_point(data = d3) +
  scale_fill_brewer(palette = "Greys") +
  scale_color_brewer(palette = "Set2")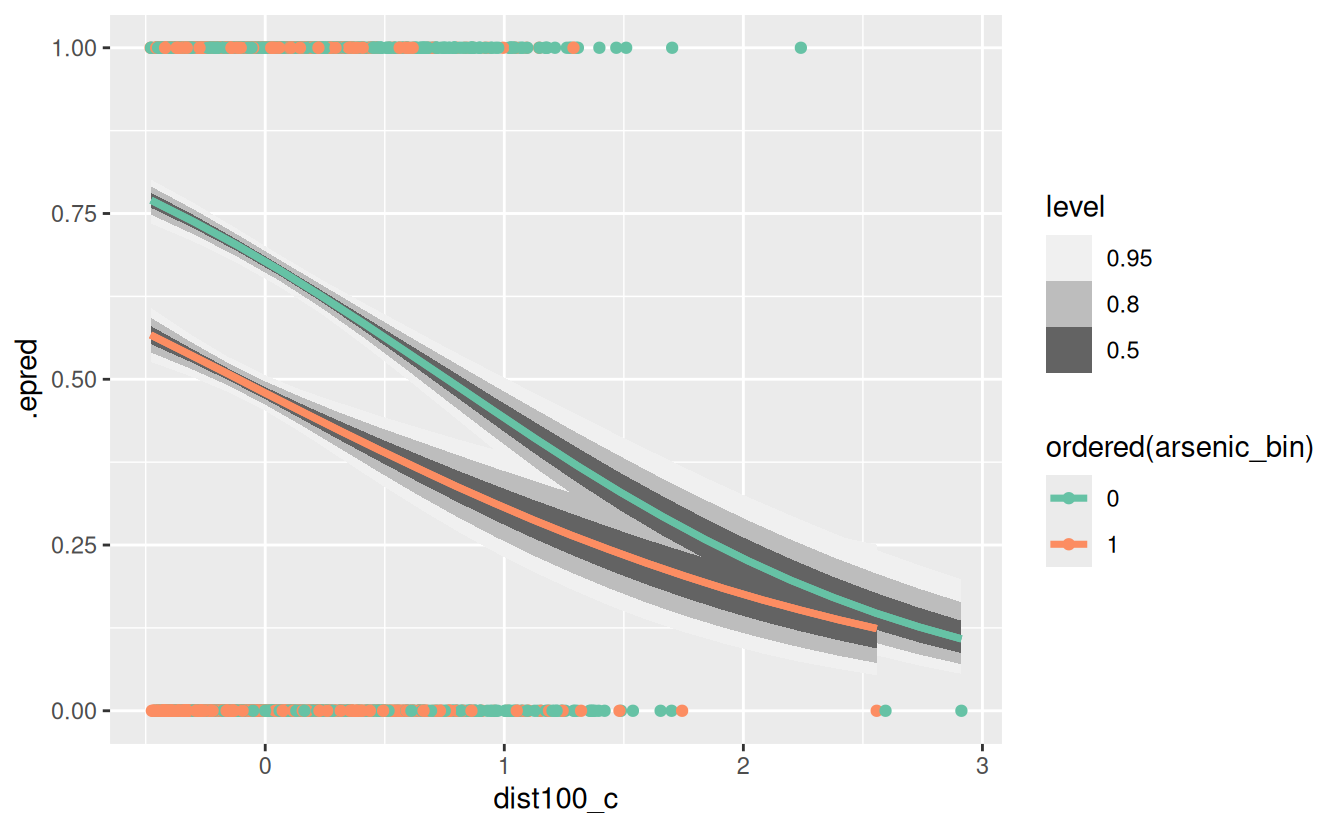
Vergleichen wir dazu die Standardfehler in einem Modell ohne Interaktion, m4. Wir lassen die Interaktion weg, um zu prüfen, ob es Effekte auf die Standardfehler gibt, die unabhängig von der Interaktion (bzw. der dadurch erzeugten Kollinearität) sind.
m1 <- stan_glm(switch ~ dist100 + arsenic,
               family = binomial(link = "logit"),
               data = d,
               refresh = 0)

m4 <-
  stan_glm(switch ~ dist100_c + arsenic_c,
           family = binomial(link = "logit"),
           data = d2,
           refresh = 0)
Vergleichen wir die Standardfehler der Modelle. Zur Erinnerung: Der Standardfehler ist eine Möglichkeit, die Ungewissheit des Modells zu quantifizieren.
Standardfehler im nicht-zentrierten Modell (ohne Interaktion):
se(m1)(Intercept) dist100 arsenic
0.07988082 0.10067669 0.04192940 Standardfehler im zentrierten Modell (ohne Interaktion):
se(m4)(Intercept) dist100_c arsenic_c
0.03761498 0.10157913 0.04143804 Wie wir sehen, wirkt sich die Zentrierung nur (günstig) auf den Achsenabschnitt aus, aber nicht auf den Standardfehler des Regressionskoeffizienten.
Aufgabenname: bangladesh2
Meta-information
exname: bangladesh2 extype: string expoints: 1 exsolution: NULL